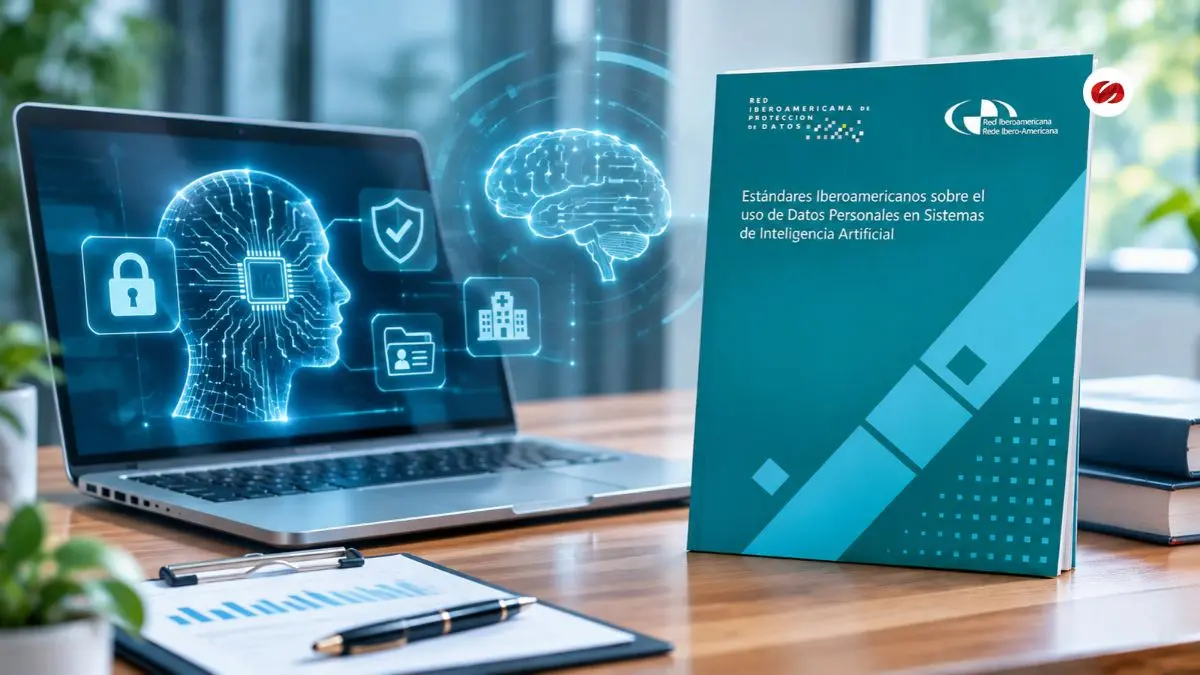
Los sistemas de inteligencia artificial pueden inferir información sensible sobre la salud de las personas a partir de datos aparentemente neutros y utilizarla para generar perfiles o apoyar decisiones automatizadas. En este contexto, la Superintendencia de Industria y Comercio (SIC) publicó los Estándares Iberoamericanos sobre el uso de Datos Personales en Sistemas de IA, aprobados por unanimidad por las autoridades de la Red Iberoamericana de Protección de Datos (RIPD), que contemplan criterios sobre transparencia, protección de información sensible y supervisión humana.
El instrumento, elaborado en colaboración con la Fundación para la Internacionalización de las Administraciones Públicas (FIAP), está dirigido a autoridades de protección de datos, legisladores, responsables y encargados del tratamiento, proveedores tecnológicos y organizaciones públicas y privadas. Su contenido comprende operaciones realizadas con información personal durante el desarrollo, entrenamiento, utilización y evaluación de sistemas de inteligencia artificial (IA), incluidas las inferencias y los resultados que estos generan.
Estándares iberoamericanos establecen criterios para el tratamiento de datos personales en sistemas de IA
Los estándares desarrollan principios de licitud, finalidad, minimización, calidad, transparencia y explicabilidad en el tratamiento de datos personales. También contemplan garantías relacionadas con los derechos de los titulares, las responsabilidades de las organizaciones, la seguridad de la información y las medidas aplicables cuando los sistemas de inteligencia artificial utilizan categorías especiales de datos.
La RIPD establece que el instrumento tiene carácter orientador y complementario respecto de los regímenes generales de protección de datos personales. Sus disposiciones no sustituyen las legislaciones nacionales ni constituyen una regulación independiente de los modelos tecnológicos, sino que desarrollan criterios para aplicar las garantías existentes a los tratamientos realizados mediante inteligencia artificial.
Datos de salud inferidos mediante inteligencia artificial requieren protección reforzada
Una de las disposiciones contempla las inferencias sensibles, es decir, información que los sistemas de IA pueden deducir sobre características personales. Mediante el procesamiento de diferentes variables, estas herramientas pueden obtener información relacionada con condiciones de salud, creencias, ideología u orientación sexual, aun cuando los datos utilizados inicialmente no pertenezcan a categorías especiales.
Los estándares precisan que la protección reforzada depende de la naturaleza de la información inferida y no únicamente de los datos empleados para generarla. Cuando un sistema permita atribuir razonablemente a una persona características comprendidas en categorías especiales, deberán observarse las garantías previstas en la normativa aplicable, considerando la finalidad, el contexto y los efectos del tratamiento.
Esta protección también comprende inferencias que presentan incertidumbre, pues su grado de fiabilidad o exactitud no excluye, por sí solo, la aplicación de garantías reforzadas cuando se utilizan para adoptar o apoyar decisiones sobre una persona. El documento incluye, además, criterios relacionados con el tratamiento de neurodatos y de información correspondiente a personas o grupos en situación de vulnerabilidad.
Transparencia y uso de información personal en sistemas de inteligencia artificial
La SIC destacó que el acceso público a determinada información no autoriza automáticamente su utilización para entrenar sistemas de inteligencia artificial. Los estándares también precisan las condiciones para reutilizar datos personales y las garantías de transparencia que deben observarse cuando se generan perfiles o resultados mediante estas tecnologías.
Entre las principales disposiciones se encuentran:
- Datos disponibles públicamente: su accesibilidad no constituye, por sí sola, una base jurídica suficiente para utilizarlos en el entrenamiento de modelos de inteligencia artificial.
- Deber de informar: comunicar que se utiliza IA no necesariamente resulta suficiente; deben explicarse sus finalidades, la función que desempeña y las posibles consecuencias del tratamiento.
- Perfiles e inferencias: las predicciones y los resultados generados por estos sistemas pueden constituir datos personales cuando se relacionan con individuos identificados o identificables.
- Reutilización de información: el uso de datos para finalidades distintas de las inicialmente previstas requiere verificar las condiciones jurídicas aplicables.
- Prácticas incompatibles: se identifican tratamientos dirigidos a manipular de manera engañosa, explotar vulnerabilidades o realizar puntuaciones sociales discriminatorias.
Estas disposiciones se relacionan con las condiciones que deben observar quienes desarrollan o utilizan sistemas automatizados para procesar información personal. El documento también establece criterios para identificar las consecuencias de estos tratamientos y garantizar que las personas reciban información sobre las operaciones que involucran sus datos.
Decisiones automatizadas deben contemplar intervención humana efectiva
Los estándares incluyen garantías para las personas cuyos datos sean utilizados en decisiones automatizadas o en procesos de elaboración de perfiles. Cuando corresponda conforme a la normativa aplicable, los titulares podrán impugnar decisiones que les afecten y solicitar intervención humana, de acuerdo con las características del tratamiento realizado.
Esta intervención debe ser efectiva y no limitarse a confirmar automáticamente los resultados generados por inteligencia artificial. También se contemplan medidas para identificar y prevenir efectos discriminatorios, así como mecanismos de revisión que permitan examinar las consecuencias de las decisiones automatizadas sobre las personas.
En relación con los derechos de los titulares, los estándares abordan el acceso y la supresión de información personal utilizada por sistemas de IA, incluidos datos incorporados en modelos previamente entrenados. Cuando no sea técnicamente posible eliminar completamente determinada información, el responsable deberá justificar esa circunstancia, informar al titular y adoptar las medidas correspondientes previstas en el instrumento.
Responsabilidades y medidas de protección para las organizaciones que utilizan IA
El documento distingue las responsabilidades de las organizaciones que intervienen en el desarrollo y utilización de sistemas de inteligencia artificial, incluidas aquellas que contratan soluciones tecnológicas de terceros. También contempla criterios sobre documentación de los tratamientos, gestión de riesgos, transferencias internacionales de información y evaluaciones de impacto.
| Ámbito | Criterio contemplado en los estándares |
|---|---|
| Responsables del tratamiento | Mantienen sus responsabilidades cuando determinan los fines y medios esenciales del tratamiento, aunque utilicen tecnologías desarrolladas por terceros. |
| Proveedores de IA | La utilización de información de clientes para entrenar o mejorar modelos propios requiere una habilitación jurídica adecuada. |
| Evaluación de impacto | Debe realizarse cuando resulte exigible conforme a la normativa aplicable y se recomienda ante tratamientos que puedan representar riesgos elevados. |
| Seguridad de los datos | Se contemplan controles frente a filtraciones, reidentificación, extracción de información y accesos no autorizados. |
| Gobernanza algorítmica | Comprende documentación, distribución de responsabilidades, formación, supervisión y revisión de las medidas adoptadas. |
En materia de seguridad, los estándares identifican amenazas relacionadas con la extracción de datos de entrenamiento, la inversión de modelos, la reidentificación y la inyección de instrucciones. Para estos escenarios contemplan medidas técnicas y organizativas destinadas a gestionar los riesgos y responder a incidentes que puedan comprometer la información personal.
¿Qué establecen los estándares sobre inteligencia artificial generativa?
La inteligencia artificial generativa cuenta con disposiciones relacionadas con el ingreso de información personal en las instrucciones suministradas a estos sistemas. Los estándares contemplan medidas para evitar la incorporación innecesaria de datos propios o de terceros y definir las condiciones para conservar, utilizar o reutilizar tanto esas instrucciones como las respuestas generadas.
También incluyen medidas para prevenir la divulgación, recuperación o memorización indebida de información personal. Cuando los resultados producidos por estos sistemas puedan emplearse para adoptar decisiones sobre personas, deberán verificarse conforme a las condiciones del tratamiento. En los procesos de desarrollo y entrenamiento se contemplan criterios sobre la documentación del origen de los datos utilizados.
El documento aborda igualmente particularidades relacionadas con los sistemas biométricos, el reconocimiento de emociones y las herramientas utilizadas para puntuación, selección o priorización de personas. Estas disposiciones se refieren al tratamiento de información personal mediante dichas tecnologías y a las garantías establecidas en los regímenes de protección de datos aplicables.
¿Cómo se protegerán los datos personales utilizados por sistemas de inteligencia artificial autónomos?
Los estándares incluyen criterios para la inteligencia artificial agéntica, es decir, sistemas capaces de acceder de manera autónoma a información personal o ejecutar acciones sobre ella. En estos casos, el responsable deberá determinar el nivel de autonomía permitido de acuerdo con las operaciones que pueda realizar el sistema y sus posibles efectos sobre las personas, contemplando una supervisión más intensa cuando dichos efectos sean mayores.
También se establece la necesidad de delimitar los datos, herramientas, servicios y recursos a los que puede acceder el sistema, junto con mecanismos que permitan conocer y revisar sus actuaciones. Las medidas contemplan la supervisión humana y la posibilidad de suspender o interrumpir operaciones independientemente del propio sistema cuando resulte necesario proteger los derechos de las personas.
Respecto de las memorias persistentes, el documento precisa que su utilización para conservar o reutilizar datos personales debe observar los principios de finalidad y limitación del plazo de conservación. Cuando una actuación autónoma implique una finalidad distinta de la inicialmente prevista, deberá verificarse que exista una base jurídica adecuada y, cuando corresponda, que esa finalidad sea compatible con la original.
La autonomía operativa de estos sistemas tampoco modifica las responsabilidades de las organizaciones y demás participantes en el tratamiento de información personal. Bajo este alcance, los Estándares Iberoamericanos constituyen un instrumento de referencia para autoridades y organizaciones, cuyos criterios deben interpretarse conforme a los marcos normativos de cada país y a las condiciones particulares en las que se utilizan estas tecnologías.
¿Qué implicaciones tienen los estándares de inteligencia artificial para el sector salud colombiano?
La incorporación de inteligencia artificial en procesos de atención, aseguramiento, investigación y gestión de servicios de salud involucra el tratamiento de información personal que puede incluir datos clínicos, antecedentes médicos y perfiles individuales. Para las EPS, IPS y demás organizaciones del sector, los estándares iberoamericanos ofrecen criterios de referencia sobre las condiciones de utilización de estos datos, particularmente cuando los sistemas generan inferencias, apoyan decisiones sobre pacientes o utilizan información para desarrollar y entrenar modelos.
En Colombia, la Ley 1581 de 2012 reconoce los datos relativos a la salud como información sensible y establece condiciones especiales para su tratamiento. A este marco se suma la Circular Externa 002 de 2024 de la SIC, que contiene lineamientos para el uso de datos personales en sistemas de inteligencia artificial. Los estándares de la RIPD constituyen una referencia complementaria para examinar estas actividades, sin sustituir las disposiciones nacionales.
Uno de los aspectos de mayor relevancia para el sector sanitario es el tratamiento de información derivada. Los sistemas de IA pueden generar predicciones sobre condiciones de salud a partir de variables que inicialmente no se consideran sensibles. En estos casos, los estándares precisan que la protección reforzada depende de la naturaleza de la información obtenida y de su capacidad para atribuir razonablemente una condición sensible a una persona, incluso cuando la inferencia presente cierto grado de incertidumbre.
Esta disposición también resulta pertinente para las herramientas que apoyan procesos asistenciales o administrativos mediante clasificaciones, perfiles o recomendaciones individuales. Cuando una decisión automatizada produce efectos jurídicos o afecta significativamente a una persona, los estándares contemplan garantías de información, explicación, impugnación e intervención humana efectiva, de acuerdo con el régimen aplicable. La revisión humana debe permitir comprender y evaluar el resultado, así como modificarlo o apartarse de él cuando corresponda.
La utilización de plataformas tecnológicas externas constituye otro ámbito relevante. El documento establece que una organización que determina los fines y medios esenciales del tratamiento mantiene las responsabilidades correspondientes, aunque utilice herramientas desarrolladas por terceros. También aborda la reutilización de información para entrenar modelos, la seguridad de los datos y las condiciones para realizar tratamientos con finalidades diferentes de las inicialmente previstas.
En este contexto, los criterios de la RIPD permiten identificar varios asuntos para las organizaciones sanitarias que incorporan estas tecnologías:
- Protección de información clínica: considerar tanto los datos originales como las inferencias y perfiles individuales que puedan revelar condiciones de salud.
- Transparencia con los titulares: identificar las finalidades del tratamiento, el papel de la inteligencia artificial y las consecuencias que pueda tener su utilización.
- Supervisión de decisiones automatizadas: contemplar las garantías de revisión e intervención humana cuando resulten aplicables.
- Relación con proveedores tecnológicos: delimitar las responsabilidades de los participantes y las condiciones de acceso, conservación y reutilización de datos personales.
- Seguridad y gestión de riesgos: considerar las medidas de protección frente a accesos no autorizados, filtraciones, reidentificación y extracción de información.
La aplicación de estos criterios al sector salud debe considerar las particularidades de cada tratamiento y las disposiciones nacionales que lo regulan. Los estándares no establecen por sí mismos nuevos requisitos específicos para EPS, IPS o prestadores, pero proporcionan una referencia para examinar las garantías de protección de datos personales cuando se utilizan herramientas de inteligencia artificial en actividades sanitarias.
Descargue aquí los Estándares Iberoamericanos sobre el uso de Datos Personales en Sistemas de Inteligencia Artificial: